与 Redis 兼容的内存存储,具有原生向量搜索功能
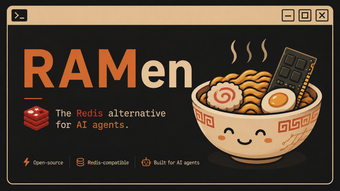
RAMen,由Rohit Dnath开发,是一个内存数据存储,旨在支持AI驱动的工作流程和代理记忆。该工具接受键值风格的访问,同时添加语义检索,以便应用程序可以通过意义而不是精确匹配来获取内容。它的目标是需要本地存储以减少延迟和避免重复模型调用的AI开发人员和后端工程师,并与使用模型上下文交换协议的代理生态系统集成。
你实际上可以用它做什么任务?
该工具作为一个内存存储,结合了 Redis 风格的访问与向量和语义检索,用于 AI 工作负载。它接受 Redis 协议命令,提供基于意义的语义缓存以进行查找,并运行一个模型上下文协议服务器,代理可以直接查询。核心实现是用 Go 编写的,并针对内存性能进行了优化,因此用例包括快速本地检索代理内存、会话上下文和缓存的 LLM 答案。
语义检索在 AI 工作流中的准确性如何?
语义缓存根据意义而非确切的关键字匹配存储和检索 AI 答案,这种设计旨在减少 LLM 调用并降低检索过程中的延迟。原生向量搜索处理高维嵌入以支持这些查找。输出反映索引和嵌入质量,因此团队在依赖缓存响应用于事实或高风险决策之前,应验证其与应用数据的一致性。
它支持哪些环境和客户端?
分发模型是一个单一的 Go 二进制文件,这简化了在可以执行 Go 程序的系统上的部署。该工具实现了一个即插即用的 Redis 协议,因此现有的 Redis 客户端和代码库可以在不进行重大修改的情况下进行交互。对于代理工作流,它与任何支持模型上下文协议的 AI 客户端或平台集成,命名示例包括 Claude Desktop 和 Cursor,使代理能够直接访问数据。
在现有堆栈中采用它容易吗?
采用的重点是开发人员的易用性和开源准备性。BSD-3-Clause 许可证和 GitHub 托管的项目使代码重用变得简单,开发者在后端系统、Node.js、TypeScript 和 Go 方面的背景表明对 API 和部署规范的重视。由于该工具面向工程师和 AI 代理构建者,因此预计将采用以开发为导向的工作流程,偏向于代码库集成、代码级配置和迭代测试,而不是图形化管理。
谁应该考虑这个工具
这个工具是一个务实的选择,适合构建代理支持服务的工程团队,这些团队需要本地检索和开发者控制。它的开源导向支持基于仓库的集成,但团队在大规模部署之前应该验证语义缓存输出与他们的数据集的一致性,并确认他们的代理可以通过所需的上下文协议访问存储。将其视为一个工程组件,而不是即插即用的最终用户产品。